
La contrastación de la eficiencia informacional en mercados de predicción exige reglas matemáticas de puntuación que evalúen la precisión epistémica y la calibración probabilística. Descomponiendo el Brier Score en sus componentes analíticos —Fiabilidad, Resolución e Incertidumbre—, los investigadores cuantitativos auditan las cotizaciones frente a las encuestas convencionales, identifican el Sesgo Favorito-Longshot y aíslan ventajas estadísticas predictivas.
1. La Hipótesis de Eficiencia en Mercados de Agregación de Información
Inspirados en la célebre tesis de Friedrich Hayek sobre el mecanismo de precios como agregador descentralizado de conocimiento disperso, los mercados de predicción operan como redes dinámicas de actualización bayesiana de creencias. En los mercados bursátiles ordinarios, las cotizaciones descuentan flujos de caja futuros ponderados por aversión al riesgo. Por el contrario, en los derivados binarios con liquidación monetaria, los contratos abonan estrictamente $0.00 o $1.00, obligando a los precios a funcionar directamente como medidas objetivas de probabilidad de consenso.
Bajo la formulación fuerte de la Hipótesis del Mercado Eficiente (HME), el precio de equilibrio P_t descuenta toda la información pública y confidencial disponible:
E[o_{t+k} | F_t] = P_t
Donde o_{t+k} ∈ {0, 1} representa la realización efectiva del suceso en el momento t+k, y F_t es la información acumulada hasta el instante t. Si el mercado es eficiente, la evolución temporal de los precios constituye una martingala sin correlación serial:
E[P_{t+1} - P_t | F_t] = 0
Para verificar empíricamente el cumplimiento de este axioma, se utilizan reglas estrictas de puntuación (proper scoring rules) que penalizan el sesgo y la sobreconfianza predictiva.
2. El Brier Score: Medida Cuadrática para Probabilidades Binarias
Formulado por el meteorólogo Glenn W. Brier en 1950, el Brier Score es una regla estrictamente propia concebida para medir la discrepancia entre pronósticos probabilísticos a priori y resoluciones empíricas a posteriori.
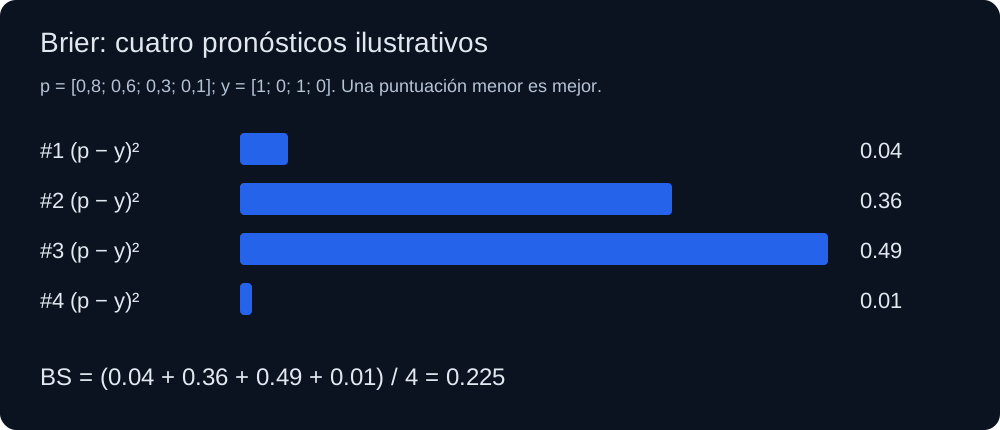
Sea N el tamaño total de la muestra de eventos resueltos. Para cada evento t ∈ {1, 2, ..., N}, sea f_t ∈ [0.00, 1.00] la probabilidad pronosticada (precio P_m), y sea o_t ∈ {0, 1} el resultado empírico verificado (1 si ocurre el suceso, 0 si no ocurre). El Brier Score (BS) se define formalmente como el error cuadrático medio:
BS = (1 / N) * ∑_{t=1}^N (f_t - o_t)^2
Propiedades fundamentales del Brier Score:
- Rango Acotado: BS ∈ [0.00, 1.00]. Una menor puntuación certifica una superior exactitud predictiva.
- Pronosticador Infalible: Asignar probabilidad 1.00 a los eventos verificados y 0.00 a los no verificados produce un BS = 0.000.
- Referencia Sin Información: Asignar sistemáticamente 0.50 a todos los eventos arroja un BS = (0.50 - 1)^2 = 0.250. Cualquier metodología que supere 0.250 resulta inferior a arrojar una moneda al azar.
- Incentivo a la Honestidad: El valor esperado del Brier Score se minimiza estrictamente cuando la probabilidad reportada f_t coincide con la convicción subjetiva real p_t del evaluador. Es analíticamente inviable mejorar la puntuación manipulando las estimaciones.
3. La Descomposición de Murphy: Fiabilidad, Resolución e Incertidumbre
En 1973, Allan H. Murphy probó que el Brier Score agregado se descompone analíticamente en tres sumandos ortogonales con significado económico específico.
Supongamos que los pronósticos se clasifican en K intervalos discretos k ∈ {1, 2, ..., K} con valores medios f_k (por ejemplo, deciles: 0.05, 0.15, ..., 0.95). Sea n_k el volumen de pronósticos en el intervalo k, y sea o_k la frecuencia empírica real observada en dicho intervalo:
o_k = (1 / n_k) * ∑_{t ∈ bin_k} o_t
Siendo ¯o la tasa base global de aciertos de la muestra: ¯o = (1 / N) * ∑ o_t. La descomposición algebraica de Murphy es:
BS = Fiabilidad - Resolucion + Incertidumbre
Donde cada magnitud se define rigurosamente como:
Fiabilidad    = (1 / N) * ∑_{k=1}^K n_k * (f_k - o_k)^2
Resolucion    = (1 / N) * ∑_{k=1}^K n_k * (o_k - ¯o)^2
Incertidumbre = ¯o * (1 - ¯o)
Implicaciones analíticas de los tres componentes:
- Fiabilidad (Error de Calibración): Mide la distancia entre las probabilidades cotizadas y las frecuencias empíricas reales. En un mercado con calibración perfecta, o_k = f_k en todos los tramos, logrando Fiabilidad = 0.000. Cualquier magnitud positiva constituye una penalización por desajuste.
- Resolución (Capacidad de Discriminación): Evalúa la habilidad del sistema para separar subconjuntos con frecuencias marcadamente distintas a la media base histórica ¯o. Una Resolución elevada reduce directamente el Brier Score, acreditando mayor agudeza en el pronóstico.
- Incertidumbre (Entropía Intrínseca): Representa el grado irreductible de aleatoriedad del entorno de estudio. Cuando ¯o = 0.50 (máxima dispersión), alcanza su techo de 0.250. Depende únicamente de los sucesos y no de la competencia del analista.
4. Tabla de Calibración: 3.236 Mercados Resueltos de Polymarket
La tabla aplica la descomposición a datos reales: 3.236 mercados Yes/No resueltos de Polymarket con un volumen de al menos $50.000, cerrados entre el 13 de marzo de 2023 y el 5 de octubre de 2026, con el último precio Yes negociado 24 horas antes del cierre. Las franjas son intervalos fijos de 0,1. Los datos, el script de análisis y los resultados completos están en nuestro estudio de calibración; una versión anterior de esta tabla usaba 2.500 contratos sintéticos y se ha sustituido.
| Franja de Precio | Mercados (n_k) | Precio Medio (f_k) | Resueltos en Yes (o_k) | f_k - o_k | Contribución a la Fiabilidad | Lectura |
|---|---|---|---|---|---|---|
| 0,00 - 0,10 | 2.433 | 0,0086 | 0,0037 | +0,0049 | 0,00002 | Sobrevalorado (claro) |
| 0,10 - 0,20 | 106 | 0,1432 | 0,1132 | +0,0300 | 0,00003 | Sobrevalorado, dentro del ruido |
| 0,20 - 0,30 | 73 | 0,2548 | 0,2192 | +0,0356 | 0,00003 | Sobrevalorado, dentro del ruido |
| 0,30 - 0,40 | 39 | 0,3415 | 0,2308 | +0,1107 | 0,00015 | Sobrevalorado, dentro del ruido |
| 0,40 - 0,50 | 36 | 0,4450 | 0,4444 | +0,0006 | 0,00000 | Cerca de calibrado |
| 0,50 - 0,60 | 41 | 0,5522 | 0,7317 | −0,1795 | 0,00041 | Infravalorado (claro) |
| 0,60 - 0,70 | 36 | 0,6542 | 0,8611 | −0,2069 | 0,00048 | Infravalorado (claro) |
| 0,70 - 0,80 | 59 | 0,7511 | 0,8644 | −0,1133 | 0,00023 | Infravalorado (claro) |
| 0,80 - 0,90 | 66 | 0,8506 | 0,8636 | −0,0130 | 0,00000 | Cerca de calibrado |
| 0,90 - 1,00 | 347 | 0,9801 | 0,9856 | −0,0055 | 0,00000 | Cerca de calibrado |
"Claro" significa que el intervalo del 95% del rendimiento de comprar Yes en esa franja excluye el cero (en la franja más baja, ese rendimiento se calcula sobre los 669 contratos cotizados por encima de 0,5¢). Las contribuciones a la fiabilidad suman 0,0013. Con una resolución de 0,1210 y una incertidumbre de 0,1457, la identidad de Murphy da 0,0013 - 0,1210 + 0,1457 ≈ 0,0260, frente a un Brier medido de 0,0259; la pequeña diferencia se debe al redondeo y a la dispersión de precios dentro de cada franja.
5. El Sesgo Favorito-Longshot: Lo Que Muestran los Datos
El Sesgo Favorito-Longshot (Favorite-Longshot Bias - FLB) es un patrón documentado en las carreras de caballos y otros mercados de apuestas: los longshots están caros respecto a la frecuencia con que ganan, y los favoritos están baratos.
Nuestros datos lo muestran en el extremo bajo. En la franja más baja el precio medio es del 0,86%, pero solo el 0,37% de esos contratos se resolvió en Yes: los longshots estaban más del doble de caros, aunque la diferencia absoluta es de apenas medio centavo. Comprar Yes en los contratos de esa franja cotizados por encima de 0,5¢ rindió −67% de media (intervalo del 95%: −92% a −43%). En la parte alta, los contratos desde 90¢ promediaban el 98,01% y se resolvieron en Yes el 98,56% de las veces, así que los favoritos estaban algo baratos, pero comprarlos rindió solo +0,60% (−0,71% a +1,91%). Los mayores errores absolutos estuvieron en el centro: en las franjas de 50–80¢, el Yes se dio en el 73–86% de los casos frente a precios medios del 55–75%, en solo 136 mercados.
Dos salvedades limitan la generalización. Cerca de tres cuartas partes de los contratos baratos (1.792 de 2.433) proceden de eventos con varios resultados, cuyos desenlaces están correlacionados; fuera de esos eventos, la franja más baja muestra un 0,84% de precio frente a un 0,78% de resolución. Y la muestra cubre solo Polymarket, con un volumen de al menos $50.000.
La literatura ofrece tres explicaciones del sesgo:
- Apetito por la Convexidad (Efecto Lotería): Los apostadores minoristas aceptan pagar de más por boletos baratos con pagos de 20x y evitan a los favoritos que pagan 1,05x.
- Ineficiencia del Capital: Como muestra nuestro análisis del criterio de Kelly, vender un longshot del 5% inmoviliza $0,95 de capital por un rendimiento del 5,26%. Los grandes operadores son reacios a bloquear capital por márgenes tan finos, lo que puede dejar caros a los longshots.
- Teoría de las Perspectivas: Daniel Kahneman y Amos Tversky mostraron que las personas sobreponderan las probabilidades bajas (π(p) > p para p < 0.10) e infraponderan las moderadas y altas.
6. Log-Loss y Divergencia de Kullback-Leibler
Mientras el Brier Score mide el error cuadrático, la teoría de la información usa la Regla de Puntuación Logarítmica (Log-Loss / Entropía Cruzada), que castiga mucho más los errores confiados:
LogLoss = - (1 / N) * ∑_{t=1}^N [ o_t * ln(f_t) + (1 - o_t) * ln(1 - f_t) ]
A medida que la probabilidad asignada a un resultado que no ocurre se acerca a 1, la penalización crece sin límite; al 99,9% ya es -ln(1 - 0.999) = -ln(0.001) = 6.908. El log-loss esperado es igual a la entropía de la distribución verdadera más la divergencia de Kullback-Leibler (KL) D_{KL}(P_{true} || P_{market}), así que, en un mismo conjunto de eventos, un log-loss menor significa una divergencia menor respecto a la verdad:
D_{KL}(P || Q) = ∑_{x} P(x) * ln( P(x) / Q(x) )
La misma magnitud mide la oportunidad de negociación. Un operador que conoce las probabilidades verdaderas P y apuesta según Kelly contra los precios de mercado Q, sin comisiones, hace crecer su capital a una tasa logarítmica esperada igual a D_{KL}(P || Q); cuanto más cerca de la verdad está el mercado, menos hay que ganar. Como referencia, nuestros 3.236 mercados de Polymarket tienen un log-loss de 0,0914 a 24 horas del cierre y de 0,1449 a 7 días (3.104 mercados con precio a 7 días).
7. Mercados de Predicción frente a Encuestas y Expertos
La comparación a largo plazo más conocida es la de Berg, Nelson y Rietz (2008, International Journal of Forecasting). Compararon los precios de cuota de voto del Iowa Electronic Markets con 964 encuestas nacionales en las cinco elecciones presidenciales de EE. UU. entre 1988 y 2004. El mercado quedó más cerca del resultado final el 74% de las veces, y su ventaja fue más clara a más de 100 días de la elección. Es una comparación directa sobre las mismas preguntas, no un Brier score.
Nuestros datos no permiten ordenar mercados y encuestas, porque no tenemos previsiones de encuestas equivalentes. Sí muestran cuánto depende un Brier score del conjunto de preguntas. El Brier de 0,0259 a 24 horas parece excelente sobre todo porque 2.780 de los 3.236 mercados (86%) ya cotizaban por debajo de 10¢ o desde 90¢ un día antes del cierre. A 7 días del cierre el valor es 0,0435 en los 3.104 mercados con precio a 7 días, y el 79% de ellos estaba en esos extremos. Los Brier scores solo son comparables sobre los mismos eventos y al mismo horizonte, así que una cifra única de "mercados de predicción" frente a "encuestas" dice poco sin ese emparejamiento.
8. Herramienta de Calibración Interactiva y Descomposición de Murphy
Para verificar sus modelos probabilísticos y contrastar el rendimiento con históricos de mercado, los operadores cuantitativos construyen procesos automatizados de evaluación de Brier.
Le invitamos a auditar la precisión de sus pronósticos, computar los coeficientes de Fiabilidad y Resolución de Murphy y visualizar curvas de calibración con nuestro evaluador interactivo:
Lanzar Analizador de Calibración de Brier Score →
Dominar las reglas estrictas de puntuación y la descomposición analítica de la calibración permite a los analistas cuantitativos identificar anomalías estructurales y asignar capital con respaldo estadístico.
