
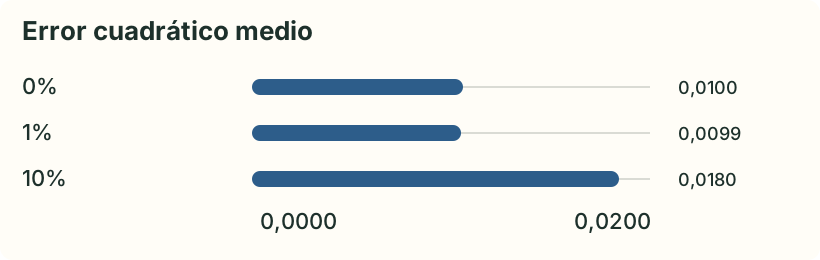
Una previsión que dice «NO» siempre acierta 99 de 100 resultados binarios si solo sucede un evento. Si asigna probabilidad exactamente cero a cada caso, su Brier score es 0,0100. Parece poco en una escala que llega hasta uno. Para interpretarlo hay que conocer la frecuencia del suceso y el resultado de una previsión que carezca de información sobre cada caso concreto. Comparemos con una previsión que atribuye un 1% a todos los casos.
Conserva los resultados y cambia la previsión
Considera 100 contratos inventados. Exactamente uno se resuelve como SÍ y los otros 99 como NO. Es una hoja de ejercicios con una solución fijada. No contiene operaciones de una plataforma ni estima la incidencia real de eventos raros. En cada fila de la tabla puntuamos los mismos 100 resultados. La referencia del 1% está fijada de antemano en este ejercicio. En una evaluación real tendría que estar disponible antes de conocerse los desenlaces.
Para una probabilidad p de SÍ y un resultado y, que vale uno si es SÍ y cero si es NO, la penalización es (p − y)². Promediamos las penalizaciones de los 100 contratos. La previsión de cero incurre en un punto por el único SÍ y en cero por los demás. Con el 1%, el SÍ cuesta 0,9801 y cada NO cuesta 0,0001. Al sumar y promediar obtenemos 0,0099. Las dos previsiones pueden dar las mismas decisiones binarias con un umbral del 50% y aun así recibir distintas puntuaciones probabilísticas.
| Probabilidad fija de SÍ | Brier score | Skill frente al 1% |
|---|---|---|
| 0% | 0,0100 | −0,0101 |
| 1% | 0,0099 | 0,0000 |
| 10% | 0,0180 | −0,8182 |
| 50% | 0,2500 | −24,2525 |
La fila del 10% revela algo que queda oculto al comentar únicamente el error de clasificación del caso positivo. Reduce la penalización del SÍ a 0,81. En los 99 negativos aumenta la de cada uno a 0,01. El total es 1,80 y el promedio es 0,0180. Una previsión constante del 50% recibe 0,25 en cada caso. Si solo usamos ese valor como referencia, todas las previsiones de probabilidad baja parecen buenas. Es una prueba demasiado fácil con esta mezcla de sucesos.
Puntúa el modelo y la referencia sobre las mismas filas
El Brier skill score es uno menos el score del modelo dividido por el de la referencia. Usa los mismos resultados, pesos y cortes temporales para las dos puntuaciones. Frente a 0,0099, el pronóstico siempre NO con 0,0100 obtiene aproximadamente −0,0101 en unidades de skill score. La previsión del 10% obtiene aproximadamente −0,8182. Cero indica igualdad con la referencia elegida. Uno corresponde a la previsión perfecta si la referencia tiene error positivo. Un valor negativo indica más error cuadrático que el de la referencia.
La diferencia de 0,0001 entre las dos filas inferiores importa porque la referencia también es pequeña. Una medida relativa puede parecer drástica cuando un evento raro deja poco margen de mejora. Yo pondría los scores brutos y el número de casos junto al skill score. Una etiqueta de rendimiento negativo sin el nombre de la referencia ni el denominador esconde la parte que hay que revisar. Si la referencia obtiene error cero en el conjunto evaluado, la división queda indefinida. Todavía se pueden publicar las dos puntuaciones brutas.
Decide qué podía saber la referencia
Imagina un proyecto que reúne preguntas sobre clima, ganadores de torneos y contratos con fecha límite. Una sola tasa de base para todos puede ocultar diferencias importantes en la selección de los contratos. Elige una referencia que se pueda calcular sin conocer las liquidaciones futuras. Un punto de partida razonable es la frecuencia histórica de categorías comparables, usando solo resultados ya conocidos antes de la fecha de cada previsión. Fija la regla de agrupación y explica cómo tratas una categoría con pocos casos previos. Si la tasa por grupo resulta inestable, muestra también una referencia agregada.
La hoja tiene un SÍ por construcción. Estimar la referencia a partir de esa misma solución y llamar al resultado una evaluación fuera de muestra sería circular. Para evaluar un modelo real, guarda la fecha de corte del entrenamiento y el intervalo de prueba. Registra una probabilidad por contrato con un horizonte fijo. Un ejemplo sería una captura un día antes de un plazo publicado, cuando exista tal captura. Usa la misma regla de tiempo para modelo y referencia. Excluir una previsión tras la liquidación por un precio inconveniente modifica la muestra y cambia el score.
Muestra el denominador
Incluye solo contratos con desenlace binario conocido según la regla de evaluación escrita. Documenta el tratamiento de cancelaciones, anulaciones y datos ausentes antes de calcular. Un caso cancelado requiere una regla explícita. Tratarlo como NO añadiría un resultado que la pregunta nunca resolvió. Si muchas preguntas dependen de una misma elección, partido o publicación económica, describe esa dependencia. Cien contratos referidos al mismo hecho aportan menos evidencia independiente de la que sugiere el recuento de filas. Muestra resultados por grupo de eventos cuando la muestra lo permita.
También hay un problema al comparar puntuaciones de equipos, periodos o productos distintos. En un conjunto inventado con 20 SÍ de 100, la previsión constante del 20% obtiene 0,16. En el conjunto raro, la constante del 1% obtiene 0,0099. Ninguna de ellas ordena los casos dentro de su propio conjunto. El score menor acompaña a una tasa base diferente. Siempre que puedas, puntúa los modelos sobre las mismas filas. Si deben evaluarse en conjuntos diferentes, indica la composición de cada uno, su referencia y cualquier cambio de cobertura.
Cuando no hay ningún SÍ en la ventana
Conserva la ventana si cumple la regla original de inclusión. En ese intervalo, la previsión constante de cero obtiene cero, y la constante del 1% obtiene 0,0001. Muestra el recuento de casos y la ausencia de la clase positiva. El resultado describe cómo puntuaron las previsiones en esa ventana. El rendimiento en los casos positivos queda pendiente. Un segundo periodo con un recuento conocido de SÍ se interpreta mejor que un promedio de ventanas cuya composición no se ha publicado.
Guarda un registro que se pueda recalcular
El registro mínimo útil contiene identificador, hora de la previsión, probabilidad prevista, probabilidad de referencia y desenlace. Añade el motivo de inclusión y el peso si pueden variar. Antes de redondear, reproduce por separado los totales de SÍ y NO y comprueba que los métodos vieron exactamente los mismos casos. Un solo SÍ raro puede dominar un periodo corto. Numerador, denominador y recuento de sucesos dejan ver esa sensibilidad.
En este ejemplo, la referencia del 1% obtiene el score más bajo de las cuatro constantes. La siguiente prueba consiste en averiguar si una previsión puede elevar las probabilidades de ciertos casos sin aumentar el error de todo el conjunto. Para ello hacen falta probabilidades guardadas antes de resolver los contratos y suficientes resultados positivos para juzgar la diferencia. La hoja sintética resuelve la parte aritmética. La evidencia sobre el desempeño empieza con un registro que otro lector pueda puntuar de nuevo.
